Raptor

Raptor

lunes, 31 de marzo de 2014

Servidores DNS raíz

Los Root Servers (Servidores Raíz) son los servidores DNS principales de todo el mundo, estos se encargan de resolver las peticiones DNS para los dominios de más alto nivel. Existen 13 Root Server distribuidos en varios puntos del planeta, principalmente en Estados Unidos. Estos servidores están bajo el dominio: root-servers.org.

Todos los Root Servers usan BIND (Berkeley Internet Name Domain) como servidor DNS, excepto los servidores H, L y Kque utilizan NSD (Name Server Daemon). Los Root Servers Distribuidos utilizan anycast para mejorar y equilibrar la carga, dando un servicio descentralizado.

La distribución de los Root Servers se puede ver en la siguiente figura:


·         A – VeriSign: Está ubicado en Dulles (Virginia, EEUU). Es bastante conocida por el “escándalo” de Septiembre de 2003, que intentó establecer todas las peticiones erróneas de un dominio .com o .net a un servicio propio llamado SiteFinder. Evidentemente, multitud de personas se escandalizaron por las consecuencias de seguridad y privacidad, y en febrero de 2004 se cerraba el servicio. Se encuentra preparado ya para conexiones con IPv6:2001:503:BA3E::2:30 y actualmente usa IPv4: 198.41.0.4.
·         B – Instituto para la formación científica: Situado en Marina del Rey (California). También está preparado para conexiones IPv6: 2001:478:65::53. Y también acepta conexiones IPv4: 192.228.79.201.
·        C – Cogent Communications: Es una multinacional fundada en 1999 situada en Washington. Usa IPv4:192.33.4.12
·         D – Universidad de Maryland: Situado en la ciudad College Park. Acepta conexiones IPv4: 128.8.10.90.
·         E – Centro de investigación Ames de la NASA: El centro de investigación está situado en Silicon Valley (California). Usa conexiones IPv4: 192.203.230.10.
·         F – Consorcio de Sistemas de Internet (ISC): No es un sólo servidor físico, sino un sistema distribuido de varios servidores DNS a lo largo de diferentes lugares como Ottawa, New York, Madrid, Roma, Paris, Barcelona, Buenos Aires,… hasta 43 ciudades. Fue el primero de los 7 servidores DNS distribuidos existentes. También está preparado para conexiones IPv6: 2001:500:2f::f. IPv4: 192.5.5.241
·         G – Departamento de Defensa de EE.UU.: Se encuentra ubicado en la capital de Ohio. Usa conexiones IPv4:192.112.36.4.
·         H – Laboratorio de investigación de la Armada de EE.UU: También está preparado para conexión vía IPv6:2001:500:1::803f:235 y actualmente soporta IPv4: 128.63.2.53.
·         I – Autonomica/NORDUnet: Es otro de los servidores distribuidos que abarca hasta 31 ciudades diferentes (Helsinki, Milán, Londrés, Chicago, Bruselas…). Soporta conexiones IPv4: 192.36.148.17.
·         J – VeriSign: Su segundo servidor, a diferencia del primero, es un servidor distribuido a lo largo de 37 ciudades (Vienna, Miami, Atlanta, Seattle, Tokyo, Seúl, Praga, Madrid…). También esta preparado para conexiones IPv6:2001:503:C27::2:30 e IPv4: 192.58.128.30.
·         K – Centro de coordinación de redes IP europeas: Como los anteriores servidores, dispone de una red de distribución (Londres, Amsterdam, Frankfurt, Budapest, Delhi, …). Está preparado para conexiones IPv6:2001:7fd::1. e IPv4: 193.0.14.129.
·         L – Corporación de Internet para la Asignación de Nombres y Números: Se basa en un servidor distribuido entreLos Angeles y Miami (Estados Unidos). Soporta conexiones IPv4: 199.7.83.42.
·         M – WIDE Project: Sistema distribuido entre 6 lugares entre los que se encuentran varias ciudades de Tokyo,Seúl, Paris y San Francisco. Está también preparado para IPv6: 2001:dc3::35 y actualmente soporta IPv4:202.12.27.33.n

Referencias
  

lunes, 17 de marzo de 2014

La máquina Enigma


En esta entrada vamos a hablar de un gran invento que fue pensado para la comunicación de secretos industriales la cual cifraba y descifraba mensajes automáticamente, y aunque en años anteriores ya existían máquinas con el mismo propósito, ésta estaba mejor compuesta debido a los componentes mecánicos y eléctricos que más adelante vamos a explicar.

Está maquina fue utilizada por las fuerzas armadas alemanas ya que su inventor alemán llamado Arthur Scherbius fundó una pequeña empresa de ingeniería para la producción y comercialización de invenciones. Una de las características que hacían atractiva la máquina es que era compacta y fácilmente transportable. Exteriormente parecía una máquina de escribir de la época con idéntico teclado; pero en su versión militar estaba ajustado originalmente en orden alfabético, en lugar del usual QUERTY, el teclado carecía de números porque estos debían ser deletreados y normalmente se alimentaban con pilas.

El funcionamiento de la Máquina Enigma era el siguiente:

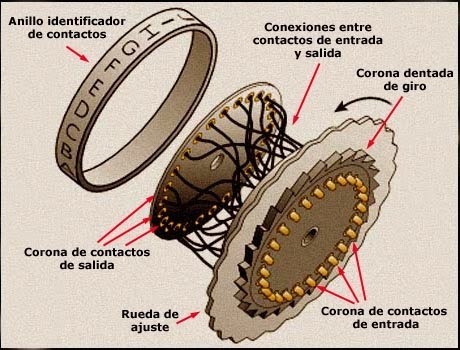
La máquina Enigma consistía de un teclado conectado a una unidad de codificación. La unidad de codificación contenía tres rotores separados cuyas posiciones determinaban como sería codificada cada letra del teclado. Lo que hacía que el código Enigma fuera tan difícil de romper era la enorme cantidad de maneras en que la máquina se podía configurar. Primero, los tres rotores de la máquina se podían escoger de un grupo de cinco, y podían ser cambiados e intercambiados para confundir a los descifradores. Segundo, cada rotor podía ser ubicado en una de veintiséis diferentes. Esto quiere decir que la máquina se podía configurar en más de un millón de maneras. Además de las conmutaciones que permitían los rotores, las conexiones eléctricas de la parte posterior de la máquina podían ser cambiadas manualmente dando lugar a más 150 millones de millones de millones de posibles configuraciones. Para aumentar la seguridad aún más, la orientación de los tres rotores cambiaba continuamente, así que cada vez que se transmitía una letra la configuración de la máquina, y por lo tanto la codificación, cambiaban para la siguiente letra. De tal forma, teclear ‘DODO” podría generar el mensaje “FGTB”: la “D” y la  “O” se envían dos veces, pero son codificadas de manera distinta cada vez.

La máquina enigma funcionaba mediante una serie de cilindros con contactos eléctricos en cada lado denominados "rotores", que al girar de cierta manera iban cambiando las "sustituciones" entre la letra de entrada y la de salida.


Podemos imaginar el efecto de un rotor como el de una permutación en las posiciones de las letras del alfabeto, con la característica que cada vez que se codifica una letra, el rotor se desplaza una posición y, por tanto, la permutación sobre el alfabeto es distinta. Sin embargo, al codificar 26 veces una letra obtendríamos su codificación inicial.


Al respecto de ésta máquina podemos decir que fue un invento muy importante y muy usual para la seguridad de la información de aquella época, por lo que si los militares la utilizaron significa que era lo bastante buena para cifrar y descifrar los mensajes. Me llama la atención de que tiene bastantes ventajas de usar esta máquina como las distintas formas para cifrar y otra cosa es que si se llegaban a repetir las letras en una palabra, las letras de salida eran distintas.

Referencias

-         John Keegan, José Adrián Vitier, Inteligencia militar: Conocer al enemigo, de Napoleón a Al Qaeda, Turner, 2012 - 464 pages
-          Alberto Mazzuca, Hitler muerde el anzuelo: Normandía: la trama oculta del Día D (Google eBook), LD Books, Aug 15, 2011

martes, 11 de marzo de 2014

Web 2.0 y Web semántica


En esta entrada vamos a describir algunas características de la Web 2.0 y la Web semántica, y la evolución de la web. Primero hay que saber que la web es una red informática mundial la cual es accesible vía internet y que el usuario visualiza con un navegador web. Mediante este navegador se pueden ver todos los contenidos de las páginas web que son texto, imágenes, video, entre otros contenidos multimedia, pero con el paso del tiempo se ha ido mejorando la interacción de la web con el usuario.

Hablando de la web 2.0, es una evolución de la web 1.0 que está guiada a la facilitación de compartir información teniendo un diseño que se enfoca en el usuario, ya que estos mismo son creadores de contenido en las páginas web.

En la Web 2.0 existen comunidades, hay nuevos servicios y aplicaciones web como es el caso de las redes sociales y alojamiento de videos para que los usuarios puedan compartirlos, foros de información, blogs, páginas que se enriquecen con información que sube cualquier persona en cualquier lugar  y entre más aplicaciones en las cuales participan los usuarios de la web. La siguiente figura ilustra la evolución de la web 1.0 a la web 2.0.


Por otro lado existe la Web semántica que está enfocada en la información de los datos dentro de la web, con fines de devolver contenido más accesible y utilizable de los recursos por parte de los buscadores de información dentro de la web.

La Web Semántica es la nueva generación de la Web, que intenta realizar un filtrado automático preciso de la información. Para ello, es necesario hacer que la información que reside en la Web sea entendible por las propias máquinas. Especialmente su contenido, más allá de su simple estructura sintáctica.

La visión de la Web Semántica es ampliar los principios de la Web desde los documentos a los datos. La misma permitirá satisfacer mayor potencial a las Web, permitiendo que los datos sean compartidos con eficiencia por grandes comunidades, y sea procesada automáticamente por las herramientas y manualmente.

Referencias
[1] Paul Anderson, “What is Web 2.0 ? Ideas, technologies and implications for education”, JISC (Joint Information Systems Committee)
[2] Cristobal Cobo y Hugo pardo, Planeta Web 2.0 inteligencia colectiva, http://www.planetaweb2.net/
[3]  Tim Berners-Lee, James Hendler, Ora Lassila, The Semantic Web, Scientific American, May 2001
[4] Web semantica: Las aplicaciones actuals, recuperado de: http://es.kioskea.net/
[5] Pablo Castells (2003) La web semántica. Universidad Autónoma de Madrid


miércoles, 26 de febrero de 2014

Factura digital en México y la firma electrónica

En esta entrada vamos a hablar un poco de la factura digital en México y la firma electrónica que son temas que van relacionados entre sí. Primero empezaremos por saber que es una factura tradicional y lo que es una firma electrónica.

Una factura tradicional es un documento en papel que refleja y justifica un pago de un servicio o productos en el cual aparece el RFC (registro federal del contribuyente) de quien la adquiere, así como el domicilio del vendedor y comprador junto con otros detalles de la compra. Este documento tiene un carácter fiscal y legal los cuales demuestran los movimientos monetarios. La factura está apegada a los estándares definidos por el Servicio de Administración Tributaria (SAT).

En México la factura electrónica es la representación digital de la factura tradicional la cual es obligatoria para todos los contribuyentes a partir del 1° de enero de 2014 siendo aún más funcional que la tradicional.

Por otro lado la Firma Electrónica Avanzada (FIEL) de acuerdo con el portal del Servicio de Administración Tributaria (SAT), es un conjunto de datos que se adjuntan a un mensaje electrónico, cuyo propósito es identificar al emisor del mensaje como su autor legítimo, como si se tratara de una firma autógrafa.

La FIEL es un medio electrónico con el que el contribuyente puede llevar a cabo transacciones fiscales electrónicas y dar su autorización para ejecutarlas a través de esta herramienta; es decir, es un medio de autorización electrónica. 
Ahora que ya conocemos qué es la factura digital y la firma electrónica, debemos saber que la información firmada digitalmente es equiparable a los documentos impresos con firma autógrafa, teniendo igual valor y produce los mismos efectos que las leyes otorgan a estos documentos.

En la administración pública la firma digital inicia una nueva etapa, al permitir reducir el uso de papeles y oficios. Al brindar certeza jurídica la firma digital permite un nuevo modelo de control de gestión electrónica, en el cual se eliminen los costos asociados a una gestión en papel. 

Así, las organizaciones públicas que adoptan este modelo reducirán significativamente costos en espacios para mantener archivos, costos de traslados al llevar un documento de una oficina a otra, y costos asociados a la digitalización de documentos.

Esta firma aumentará el aprovechamiento de tecnologías de información y comunicaciones a través de la sistematización y digitalización de los trámites administrativos para la gestión pública, brindando una mejor atención a los ciudadanos al agilizar, simplificar y transparentar las operaciones que realicen con las dependencias gubernamentales.


Referencias
-          Cámara de diputados, secretaría General Ley de firma electrónica avanzada, http://www.diputados.gob.mx/LeyesBiblio/pdf/LFEA.pdf
-          Servicio de administración tributaria, http://www2.sat.gob.mx/sitio_internet/informacion_fiscal/18_3462.html
-          Secretaría de educación pública, Declaración de Modificación patrimonial, http://www.funcionpublica.gob.mx/index.php/temas/declaracion-de-modificacion-patrimonial.html
-          Secretaría de la función pública, Firma Electrónica avanzada, http://www.funcionpublica.gob.mx/index.php/ua/ssfp/funcion-publica/firma-electronica-avanzada-fiel.html

lunes, 24 de febrero de 2014

Protocolos de Switch

Spanning Tree Protocol

Es una tecnología dentro del área de las redes de computadoras que trabaja de la siguiente manera.
Suponiendo que tenemos un conjunto de computadoras que se comunican todas entre si. Las computadoras están divididas en subgrupos y conectados a dispositivos Switches los cuales permiten la comunicación entre todas las computadoras. Como los equipos están conectados todos contra todos, es posible que cuando una máquina envíe un mensaje a otra existan varios caminos para llegar a su destino, es decir, tiene demasiadas rutas alternativas hacia un mismo destino y muchas veces pasar varias veces por un mismo camino teniendo ciclos. La función del Spanning Tree Protocol es que no existan ciclos dentro de la topología de red donde existan varios Switches para llegar a una máquina, ésto lo realiza apagando algunas puertas del switch que generan algún posible camino.

Broadcast Storm Control

Si hablamos de la misma topología del ejemplo anterior. Suponiendo que exista una difusión de mensajes a todos los destinos posibles puede existir mucho tráfico por donde viaja la información, pudiendo ser los cables o los dispositivos de comunicación como los switches. El Broadcast Storm Control tiene la funcionalidad de limitar el número de mensajes enviados para mejorar el rendimiento de la red y que no exista tráfico, ya que esto es un problema cuando el ancho de banda o la capacidad del canal llega a sus límites.


Referencias:

jueves, 13 de febrero de 2014

Servicios JAVA

JAAS (Java Authentication and Authorization Service) es una interfaz que permite a las aplicaciones Java acceder a servicios de control de autenticación y acceso. Apareció como paquete opcional en la versión 1.3 y lleva siendo parte del estándar desde la versión 1.4.

Puede usarse con dos fines:

    - la autenticación de usuarios: para conocer quién está ejecutando nuestro código java,

    - la autorización de usuarios: para garantizar que quién lo ejecuta tiene los permisos necesarios para hacerlo.


La Autenticación Java y Servicio de autorización (JAAS) es un conjunto de interfaces de programación de aplicaciones (API) que puede determinar la identidad de un usuario o un equipo de intentar ejecutar Java de código y asegurarse de que la entidad tiene el derecho de ejecutar las funciones requeridas. En este contexto, la autenticación es el proceso de determinar si existe o no una entidad es quien o lo que declara ser; autorización es el proceso de dar un permiso entidad para hacer, usar, o para obtener algo. Lógicamente, la autenticación precede a la autorización.

La EE Java Connector Architecture (JCA) define una arquitectura estándar para sistemas Java EE para Sistemas heterogéneos externos de la empresa de información (EIS). Ejemplos de estudios de impacto ambiental incluyen planificación de recursos empresariales (ERP), el procesamiento de transacciones del mainframe (TP), bases de datos y sistemas de mensajería.
JCA 1.6 proporciona funciones para la gestión de:

  • conexiones
  • transacciones
  • seguridad
  • del ciclo de vida
  • casos de trabajo
  • flujo de transacciones
  • mensaje de entrada
El API Java para Procesar XML (JAXP) es para el procesamiento de datos XML utilizando las aplicaciones escritas en el lenguaje de programación Java. JAXP aprovecha la normas analizador API simple para XML Parsing (SAX) y Document Object Model (DOM) de modo que usted puede elegir para analizar sus datos como una secuencia de eventos o para construir una representación de objeto de la misma. JAXP también soporta el estándar Extensible Stylesheet Language Transformations (XSLT), que le permite controlar la presentación de los datos y lo que le permite convertir los datos a otros documentos XML o en otros formatos, como HTML. JAXP también proporciona soporte de espacio de nombres, que le permite trabajar con DTDs que de otro modo podrían tener conflictos de nombres. Por último, a partir de la versión 1.4, JAXP implementa la API Streaming para XML (StAX) estándar.

Java Transaction API (JTA) especifica las interfaces Java estándar entre un gestor de transacciones y las partes involucradas en un sistema de transacciones distribuidas:

El servicio de transacciones Java ( JTS ) es una especificación para la construcción de un administrador de transacciones que se asigna a [ aclaración necesaria ] el Object Management Group (OMG) Transaction Service Object (OTS) que se utiliza en el Common Object Request Broker Architecture (CORBA) arquitectura. Utiliza Generales Inter-ORB Protocol (IIOP) para propagar las transacciones entre múltiples administradores de transacciones JTS.

JTS es una especificación para la implementación de un gestor de transacciones de Java. Un administrador de transacciones sirve como intermediario entre una aplicación y una o más administradores de recursos transaccionales capaces como los servidores de bases de datos y sistemas de mensajería. La especificación JTS abarca la especificación API JTA.

JavaBeans Activation Framework , o JAF , permite a los desarrolladores:
  • determinar el tipo de una pieza arbitraria de datos,
  • encapsular el acceso a la misma,
  • descubrir las operaciones disponibles en él y
  • crear una instancia del bean apropiado para realizar la operación (s).

El API Java Persistence proporciona un modelo de persistencia POJO para el mapeo objeto-relacional. El API Java Persistence fue desarrollado por el grupo de expertos de software de EJB 3.0 como parte de JSR 220, pero su uso no se limita a los componentes de software de EJB. También puede ser utilizada directamente por las aplicaciones web y clientes de la aplicación, e incluso fuera de la plataforma Java EE, por ejemplo, en aplicaciones de Java SE. Ver JSR 220 . Es un framework del lenguaje de programación Java que maneja datos relacionales en aplicaciones usando la Plataforma Java en sus ediciones Standard (Java SE) y Enterprise (Java EE).

(JMS) Java Message Service, una API de Java que permite a las aplicaciones crear, enviar, recibir y leer mensajes usando, asíncrono, la comunicación imprecisa fiable.


The JMX technology provides the tools for building distributed, Web-based, modular and dynamic solutions for managing and monitoring devices, applications, and service-driven networks. By design, this standard is suitable for adapting legacy systems, implementing new management and monitoring solutions, and plugging into those of the future.


martes, 11 de febrero de 2014

Tipos de MIME

Tipos de MIME

El protocolo HTML fue diseñado para transportar por red ficheros en formato ASCII, formados por texto plano. Ahora bien, con el progreso de las tecnologías y con la inclusión dediferentes tipos de ficheros no ASCII en las aplicaciones por Internet (imágenes, vídeos, sonidos, etc.), surgió la necesidad de transformar estos formatos a tipo ASCII (u otros juegos de caracteres compatibles), para su correcta recepción en el navegador web.
Este problema se produjo inicialmente en las aplicaciones de correo electrónico, cuando se necesitó enviar por mail ficheros no formados por texto plano, y por tanto, no compatibles con los juegos de caracteres permitidos.
Para solucionar este problema el Internet Engineering Task Force (IETF) creó en 1992 los tipos Mime (Multipurpose Internet Mail Extensions), especificaciones para dar formato a mensajes no-ASCII, de forma que pudieran ser enviados por Internet e interpretados correctamente por los programas de correo locales.
Fue tan importante la ampliación que se dió con los tipos Mime al correo que pronto se aplicaron también a los documentos web, lo que permitió incluir en las páginas HTML ficheros varios (inicialmente imágenes, y luego vídeos, sonidos, applets de Java, etc.), que dieron nueva vida a la web.
Los tipos MIME especifican los tipos de datos, como por ejemplo texto, imagen, audio, etc., que los archivos contienen. MIME adjunta a cada fichero un archivo de cabecera donde se indica el tipo y el subtipo del contenido de los datos del mismo. Gracias a esta información, tanto el servidor como el navegador pueden manejar y presentar los archivos correctamente.
Si introducimos en nuestro código HTML referencias a ficheros especiales, cuyo tipo Mime no está declarado previamente en el sistema local del usuario, el navegador web no será capaz de interpretar dicho fichero, al no saber qué tipos de datos contiene ni cómo ejecutarlo.
Los navegadores web traen por defecto configurados una serie de tipos Mime, de tal forma que sabe cómo interpretar y ejecutar los ficheros definidos mediante estos tipos, asociando en una base de datos interna los tríos extensión fichero - tipo Mime aplicación necesaria. Este es el motivo por el que no es necesario declarar manualmente el tipo Mime asociado a una imagen GIF, ya que el navegador viene configurado para "conocer" ese tipo de ficheros y saber cómo abrirlo (en este caso, lo abre el propio navegador).
Cuando instalamos un nuevo plugin (una pequeña aplicación), éste accede a dicha base de datos y se asocia a un tipo concreto de extensión de fichero y de tipo Mime, de tal forma que, posteriormente, cuando vayamos a abrir uno de los ficheros asociados a dicha aplicación, el navegador sabe cómo interpretar el fichero y qué aplicación debe llamar para su ejecución.
En ocasiones necesitamos declarar un tipo Mime o tipo de fichero manualmente; en estos casos, y para Internet Explorer en sistemas Windows, tendremos que ir al Explorardor de Windows, menú Herramientas > Opciones de Carpeta > Tipos de archivo, declarando allí la nueva asociación. En el caso de Nestcape Navigator, tendremos que ir al menú Edición > Preferencias > Aplicaciones.
Los navegadores web soportan diferentes tipos Mime, lo cual les permite recibir archivos de imágenes, de audio y de video, applets de Java, ficheros de realidad virtual, etc., a través de Internet.
Los principales tipos Mime soportados por los navegadores web son:
TipoExtensión
Imagen
image/bmp.bmp, .bm
image/x-windows-bmp.bmp
image/gif.gif
image/jpeg.jpe
image/jpeg.jpg
image/png.png
Sonido
audio/basic.au, .snd
audio/x-au.au
audio/midi.mid, .midi
audio/x-midi.mid, .midi
audio/x-wav.wav
audio/mod.mod
audio/x-mod.mod
audio/mpeg3.mp3
audio/x-mpeg-3.mp3
audio/x-pn-realaudio.ra, .ram
Video
video/avi.avi
video/x-motion-jpeg.mjpg
video/quicktime.mov
video/mpeg.mpg
application/x-shockwave-flash.swf